Inteligencia artificial para delinear tumores mamarios en 3D: datos sintéticos como punto de partida cuando los datos clínicos escasean
La tomosíntesis digital de mama (DBT, por sus siglas en inglés) es una de las técnicas más prometedoras para detectar el cáncer de mama. A diferencia de la mamografía convencional ofrece una visión cuasi tridimensional que reduce el efecto de la superposición de tejidos, lo que es especialmente útil en mujeres con mamas densas. Esa mayor información también tiene un costo: los radiólogos deben revisar decenas de cortes por examen, lo que aumenta el tiempo de lectura y la carga de trabajo.
Por eso la inteligencia artificial despierta tanto interés en esta área. Sin embargo, la mayoría de los desarrollos se han enfocado en detectar lesiones y no en segmentarlas, es decir, en definir con precisión sus límites. Para Cristina Alfaro, primera autora del estudio, investigadora de iHEALTH y académica de la Universidad de Tarapacá, se trata de tareas muy distintas.
“Detectar un tumor significa, en términos simples, responder ‘hay una lesión aquí’. Segmentar es bastante más difícil: el algoritmo debe definir exactamente dónde comienza y dónde termina el tumor, píxel por píxel o vóxel por vóxel”, explica la investigadora. En tomosíntesis el desafío es mayor porque “no tenemos una imagen tridimensional perfecta; es una modalidad pseudo-3D, con resolución limitada en profundidad y con mucha superposición de tejido mamario”.
Contar con esa delineación completa puede ser muy valioso. Una segmentación volumétrica “permite caracterizar mejor la extensión espacial, forma y relación de la lesión con el tejido circundante”, dice Cristina, y en el futuro podría apoyar evaluaciones más reproducibles y cuantitativas. Aun así, precisa que el método todavía no entrega “una medición clínica definitiva del volumen tumoral”.
El cuello de botella: pocos datos anotados
Para entrenar un sistema de segmentación no basta con saber que una imagen contiene cáncer. Un especialista tiene que marcar cuidadosamente el contorno del tumor en cada corte, y ese trabajo es lento y costoso. “Es un problema internacional. Hay bases públicas de mamografía, pero en tomosíntesis hay muchas menos, y todavía menos con tumores delineados de manera precisa”, señala Alfaro. A eso se suman la privacidad de los pacientes, el almacenamiento de grandes volúmenes de imágenes y las diferencias entre equipos e instituciones. Por esa razón, afirma, la escasez de datos anotados es hoy “uno de los principales cuellos de botella de la inteligencia artificial aplicada a imágenes médicas”.
El equipo, en el que también se encuentran Gabriel Guerra de la Universidad de Valparaíso, Claudia Prieto y Domingo Mery ambos de la Pontificia Universidad Católica de Chile, buscó una salida en los datos sintéticos: imágenes generadas in silico con VICTRE, un software de simulación desarrollado por Badano y colaboradores y validado por la FDA.
“No son imágenes creadas simplemente para ‘parecer’ una mama”, aclara Cristina. “Se parte de modelos digitales de anatomía mamaria y se simulan tanto la presencia del tumor como elementos del proceso de formación de la imagen de tomosíntesis”. Con este enfoque el grupo desarrolló BreasTomo-Synth, un conjunto de datos en el que se sabe con exactitud dónde está el tumor y cómo es, lo que permite estudiar cómo responden distintos algoritmos en condiciones controladas.
De lo simulado a lo clínico
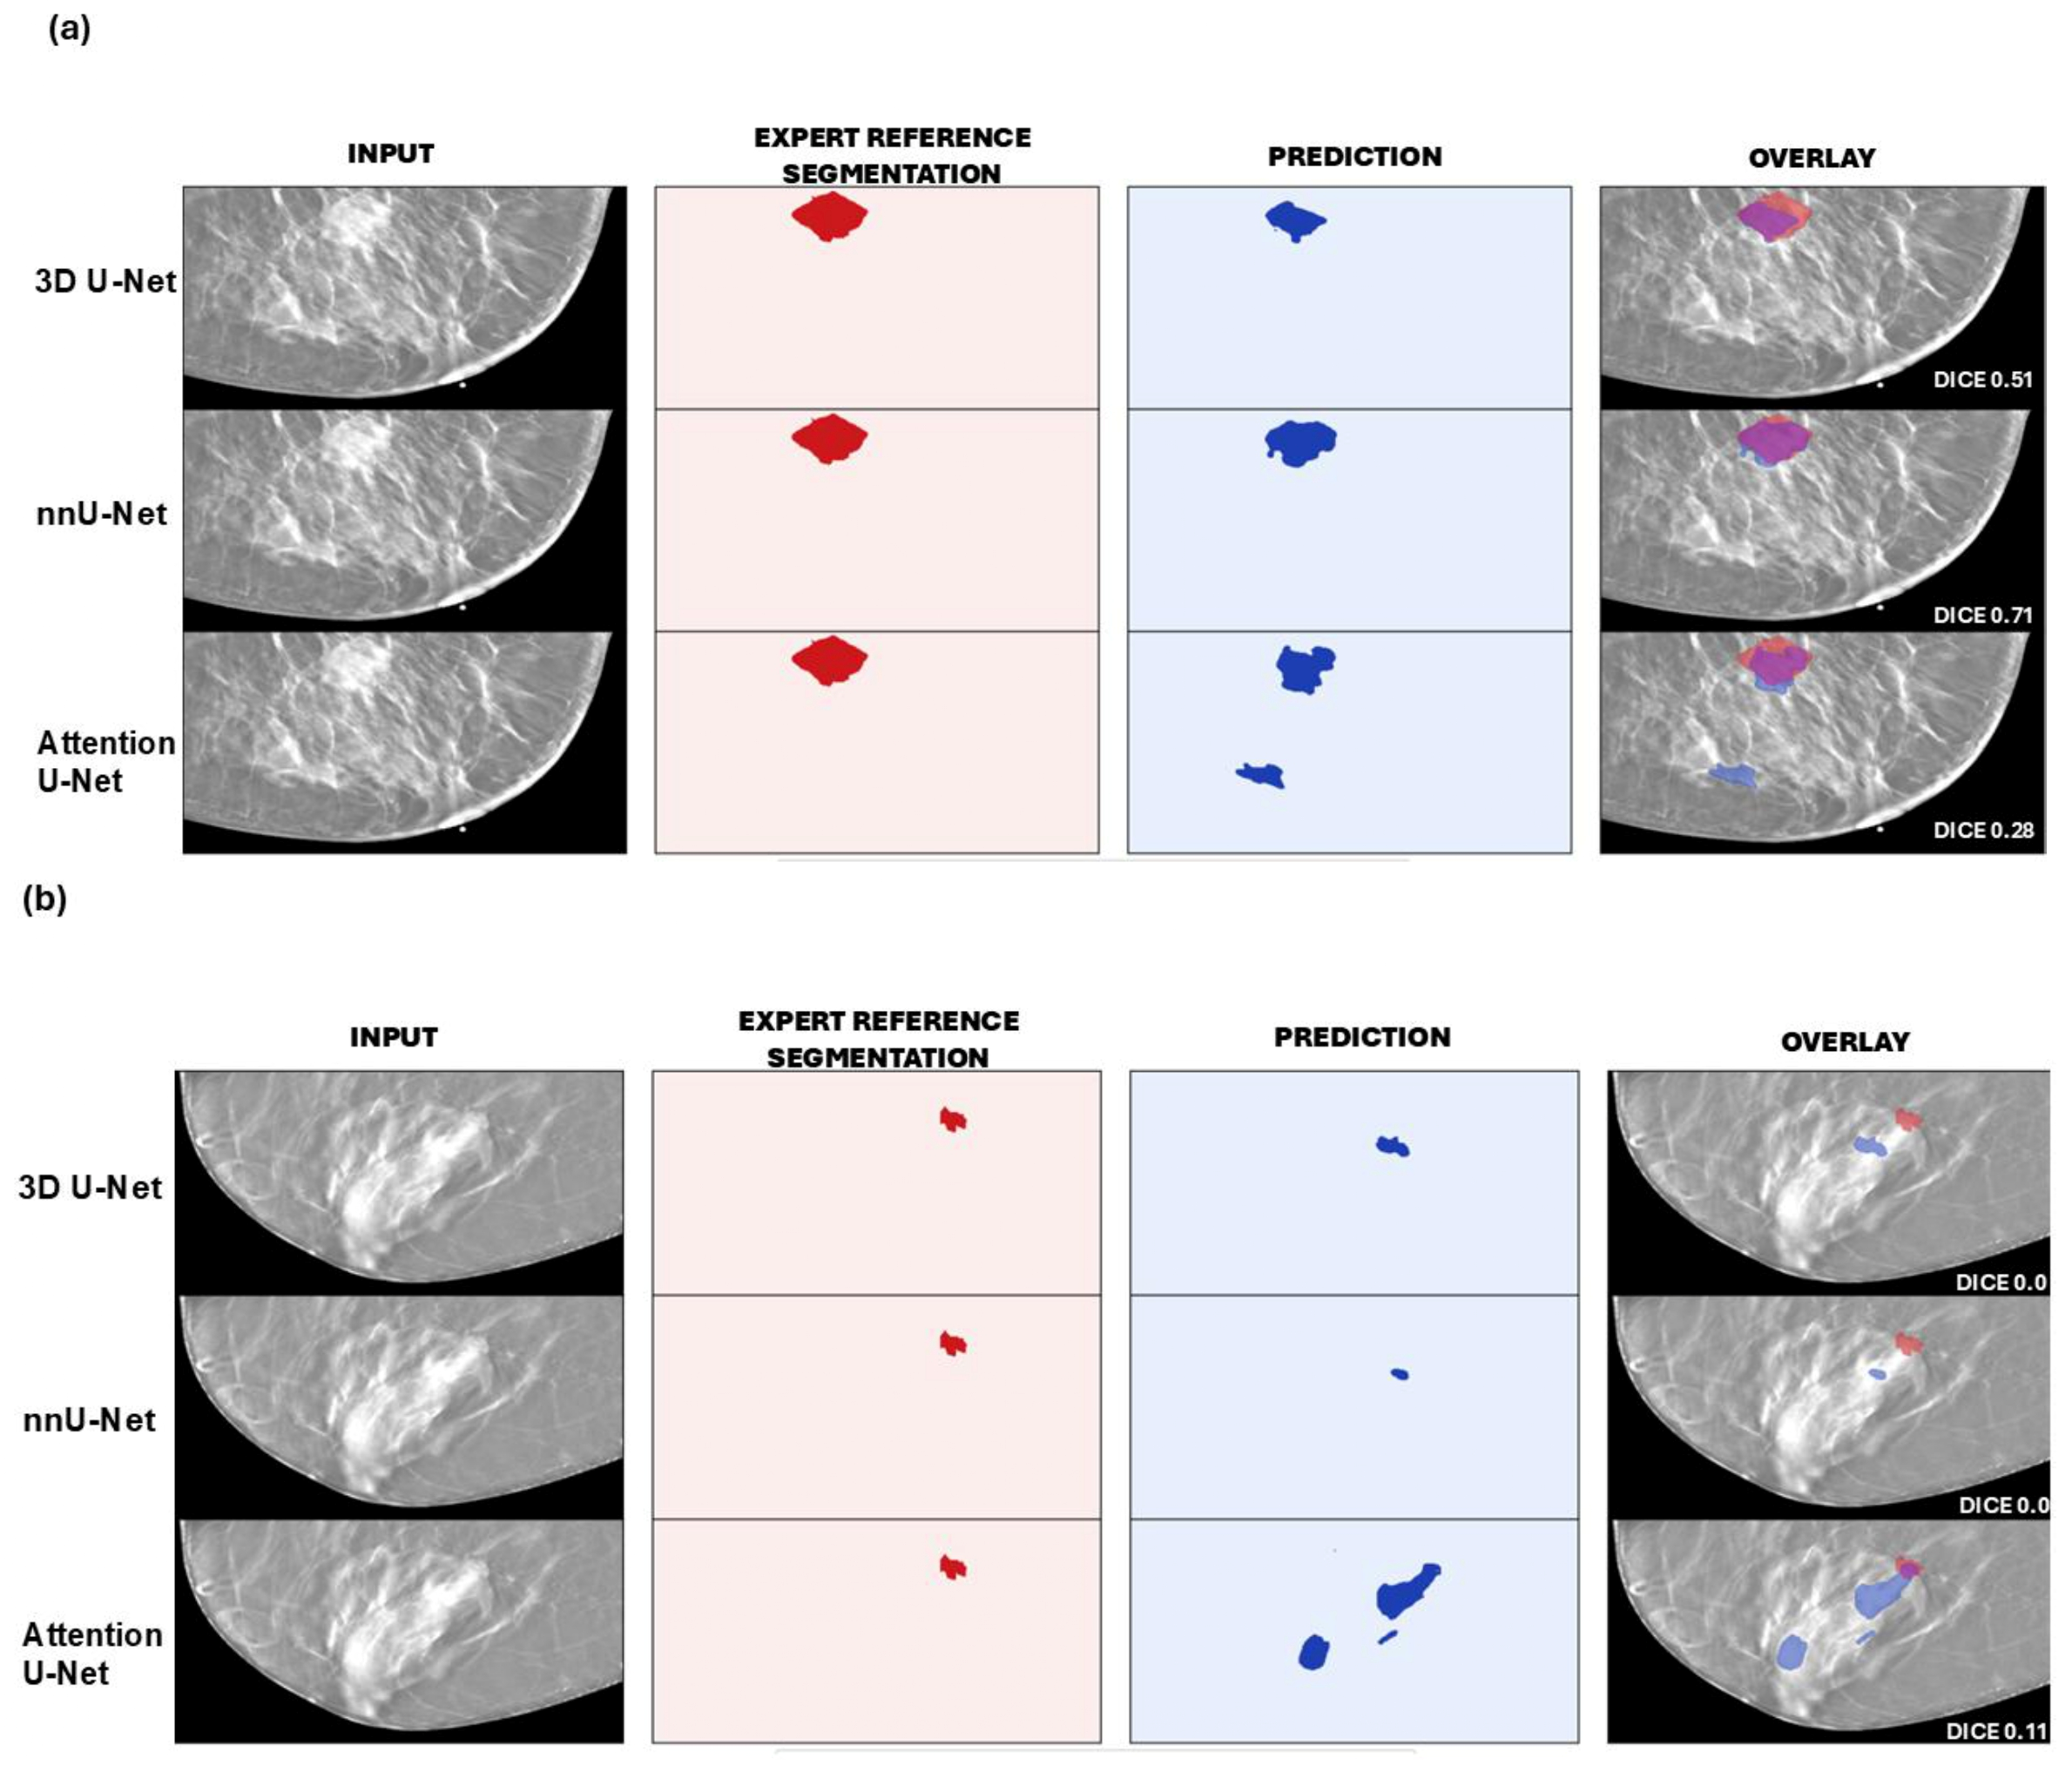
El estudio usó 120 casos sintéticos con tumores de distintos tamaños y 20 exámenes clínicos reales de la base pública BCS-DBT, todos con tumores malignos confirmados por biopsia. Se evaluaron tres arquitecturas de aprendizaje profundo: 3D U-Net, nnU-Net y Attention U-Net. A diferencia de muchos trabajos anteriores, los modelos no recibían una imagen ya recortada alrededor de la lesión. Trabajaban con bloques de 15 cortes que conservaban la mama completa, así que tenían que encontrar el tumor y además delinearlo.
La estrategia tuvo dos etapas. “Utilizamos los datos sintéticos para que los modelos aprendieran inicialmente la tarea de segmentación y después adaptarlos con una cantidad limitada de imágenes clínicas reales”, explica Alfaro. Para esa adaptación se usaron solo 10 exámenes clínicos, y los otros 10 se reservaron para la evaluación final con pacientes que el sistema nunca había visto. Al final, el equipo combinó las tres arquitecturas en un ensemble o conjunto de modelos.
Los resultados se midieron con el coeficiente Dice, que indica cuánto coincide la delineación del algoritmo con la de un experto (0 es ninguna coincidencia y 1 es coincidencia perfecta). En imágenes sintéticas, nnU-Net llegó a 0,86 con tumores grandes. En los pacientes reales el desempeño fue menor: el ensemble obtuvo el mejor promedio (0,52), seguido de nnU-Net (0,48). La diferencia del ensemble fue estadísticamente significativa frente a Attention U-Net y 3D U-Net, pero no frente a nnU-Net.
Esa caída al pasar de un escenario a otro es lo que se conoce como brecha de dominio o domain gap, y es uno de los hallazgos centrales del trabajo. “Un buen desempeño con datos sintéticos no garantiza exactamente el mismo comportamiento en imágenes clínicas”, advierte la investigadora. “Eso refuerza la idea de que los datos sintéticos son una herramienta muy valiosa, pero deben complementarse con validación clínica real”.
Aun con esa brecha, el equipo sostiene que vale la pena seguir usando simulaciones. “Si esperáramos hasta disponer de grandes bases clínicas perfectamente anotadas, muchas preguntas metodológicas podrían tardar años en investigarse”, dice Alfaro. Para ella, los datos sintéticos no reemplazan a los reales. Permiten avanzar antes y reservar los datos clínicos para donde son insustituibles: “en la validación clínica”, el siguiente paso.
Alfaro, C., Guerra, G., Prieto, C. y Mery, D. (2026). Synthetic-to-clinical ensemble learning for volumetric breast tumor segmentation in digital breast tomosynthesis under limited annotated data. Diagnostics, 16, 3046. https://doi.org/10.3390/diagnostics16183046
